llama.cpp v1.0.0: base estable para la IA local en 2026
Arquitectura estable v1.0.0
Por qué el versionado semántico consolida la inferencia local en PC.
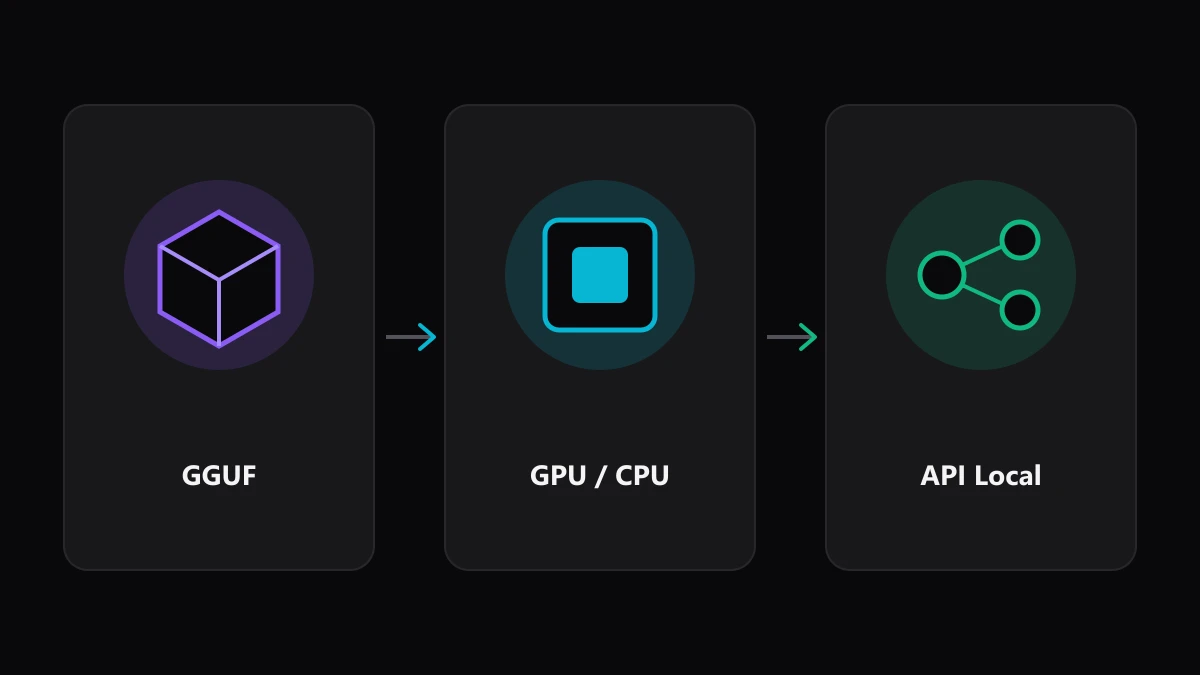
GGUF y aceleración GPU
Rendimiento con CUDA, Vulkan, Metal y cuantización moderna.
Servidor y API compatible
Despliegue local con endpoints estándar en 127.0.0.1 sin nube.
Impacto en desarrolladores
Qué cambia para herramientas CLI, editores y apps locales.
El equipo de ggml-org ha publicado oficialmente llama.cpp v1.0.0, un hito anunciado a través del Hugging Face Blog que marca el salto definitivo desde las compilaciones continuas (bXXXX) hacia el versionado semántico estable. Esta versión establece un contrato de API más predecible para desarrolladores, integradores de software y entornos empresariales que ejecutan modelos de lenguaje y multimodales directamente en hardware local sin depender de servicios en la nube.
Con llama.cpp v1.0.0, el motor escrito en C y C++ consolida su arquitectura modular sobre la librería de tensores ggml, el formato binario autodescriptivo GGUF y el servidor HTTP integrado llama-server. Para los usuarios de Windows, Linux y macOS, el lanzamiento reduce la fricción al actualizar dependencias, evita roturas silenciosas en herramientas de terceros y sienta una base técnica sólida para ejecutar inferencia offline con baja sobrecarga de memoria.
Arquitectura estable para la inferencia local
Durante años, la evolución de llama.cpp se apoyó en un ritmo acelerado de entregas diarias identificadas por número de compilación. Aunque este modelo permitió incorporar arquitecturas emergentes en cuestión de horas, obligaba a proyectos derivados y wrappers a adaptar sus llamadas internas en C de forma constante. La llegada de la versión 1.0.0 formaliza la separación de responsabilidades entre el núcleo de cálculo tensorial (ggml) y la capa de alto nivel encargada de la tokenización, la gestión del contexto y el muestreo (llama).
Desde el punto de vista técnico, esta madurez se traduce en tres garantías clave para entornos de ingeniería:
- Estabilidad en la interfaz C (
llama.h): las estructuras de contexto, carga de modelos y evaluación de lotes (batching) mantienen una semántica consistente a lo largo del ciclo 1.x, reduciendo fallos de ABI al enlazar bibliotecas dinámicas. - Gestión predecible de memoria y caché KV: el manejo mediante
mmap(mapeo de archivos en memoria) ymlockpermite cargar pesos cuantizados de varios gigabytes con un consumo controlado de RAM del sistema y reserva explícita para la caché clave-valor. - Soporte unificado para arquitecturas modernas: más allá de modelos densos basados en Transformer, el motor integra soporte consolidado para arquitecturas Mixture of Experts (MoE), modelos multimodales de visión y lenguaje, y atención optimizada mediante FlashAttention cuando el backend de hardware lo soporta.
Esta base evita que los equipos tengan que congelar versiones antiguas por miedo a regresiones en sus pipelines de automatización o asistentes de escritorio.
Rendimiento de GGUF y backends de aceleración
Uno de los pilares que explica la adopción de llama.cpp v1.0.0 es la consolidación de GGUF (GGML Universal Format) como estándar de distribución para modelos locales. Al encapsular en un único fichero los tensores de pesos, el vocabulario del tokenizador y los metadatos arquitectónicos, elimina la dependencia de múltiples archivos JSON externos y facilita la portabilidad entre sistemas operativos.
El motor mantiene su enfoque híbrido: si un modelo completo excede la VRAM de la tarjeta gráfica, el usuario puede asignar un número específico de capas a la GPU mediante el parámetro -ngl (n-gpu-layers) y procesar el resto en la CPU aprovechando instrucciones vectoriales como AVX2, AVX-512 o ARM NEON. Asimismo, la compatibilidad con esquemas de cuantización de 4, 5, 6 y 8 bits (Q4_K_M, Q5_K_M, Q6_K, Q8_0 e IQ4_XS) permite equilibrar perplejidad y ancho de banda de memoria según las capacidades del equipo.
| Backend en llama.cpp v1.0.0 | Hardware objetivo | Flag de compilación CMake | Escenario recomendado |
|---|---|---|---|
| CPU (OpenBLAS / Native) | Procesadores x86_64 y ARM64 | -DGGML_NATIVE=ON |
Servidores sin GPU o ejecución híbrida con alta RAM |
| CUDA | GPUs NVIDIA (arquitecturas Turing a Blackwell) | -DGGML_CUDA=ON |
Máximo rendimiento en estaciones Windows y Linux |
| Vulkan | GPUs AMD, Intel Arc y NVIDIA multiplataforma | -DGGML_VULKAN=ON |
Aceleración portátil sin instalar toolkits propietarios pesados |
| Metal | Apple Silicon (M1 a M4 / Ultra) | Habilitado por defecto en macOS | Memoria unificada para modelos grandes en portátiles y Mac Studio |
| ROCm (HIP) | GPUs AMD Radeon e Instinct compatibles | -DGGML_HIP=ON |
Despliegues dedicados en Linux sobre hardware AMD |
Despliegue práctico con servidor y API compatible
En la versión 1.0.0, el flujo estándar de compilación utiliza CMake como sistema único, reemplazando configuraciones heredadas basadas en Makefile que quedaron obsoletas en ciclos previos. Para compilar el proyecto desde código fuente y levantar un endpoint de inferencia local en Linux o Windows (mediante Visual Studio Build Tools o Ninja), el procedimiento consta de cuatro pasos directos:
- Clonar el repositorio oficial en la etiqueta estable:
git clone --branch v1.0.0 --depth 1 https://github.com/ggml-org/llama.cpp.git
cd llama.cpp- Configurar la compilación con aceleración por GPU (ejemplo con Vulkan para compatibilidad amplia o CUDA para NVIDIA):
cmake -B build -DGGML_VULKAN=ON -DLLAMA_CURL=ON
cmake --build build --config Release -j- Iniciar
llama-servercon descarga de capas a GPU y límite de contexto explícito:
./build/bin/llama-server \
  -m ./modelos/modelo-instruct-q4_k_m.gguf \
  -c 8192 \
  -ngl 99 \
  --host 127.0.0.1 \
--port 8080- Consumir la API compatible con OpenAI desde cualquier cliente HTTP o librería:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "local-model",
    "messages": [
      {"role": "system", "content": "Responde de forma técnica y concisa."},
      {"role": "user", "content": "Explica la función de la caché KV en inferencia."}
    ],
    "temperature": 0.2
  }'
Al exponer los endpoints estándar /v1/chat/completions, /v1/completions y /v1/embeddings en 127.0.0.1, los desarrolladores pueden redirigir sus herramientas de línea de comandos y editores de código hacia el servidor local sin enviar datos ni credenciales sensibles a proveedores externos, reforzando la privacidad frente a soluciones en la nube como detallamos en nuestra guía para ejecutar IA local en tu PC con Ollama y LM Studio.
Impacto en el ecosistema de desarrolladores
Según detalla el anuncio en el blog oficial de Hugging Face, la llegada de llama.cpp v1.0.0 no solo beneficia a quienes compilan los binarios nativos, sino a toda la cadena de herramientas que descansa sobre su motor. Soluciones de escritorio, orquestadores locales y bindings en lenguajes como Python (llama-cpp-python), Rust, Go y C# heredan un núcleo estable que facilita el empaquetado binario y la distribución mediante gestores como winget, brew o contenedores OCI.
En flujos de ingeniería modernos, disponer de una inferencia determinista y sin latencia de red también transforma las pruebas de integración de agentes autónomos. Combinado con modelos compactos de bajo coste —como los analizados en Muse Ember de Meta AI—, los equipos pueden validar flujos completos de automatización, generación de código y RAG corporativo íntegramente en su estación de trabajo, manteniendo el control absoluto sobre la privacidad de los documentos y los costes operativos.
Preguntas Frecuentes
¿Qué diferencia a llama.cpp v1.0.0 de las compilaciones anteriores tipo bXXXX?
El salto a la versión 1.0.0 introduce versionado semántico formal y estabiliza la interfaz pública en C/C++ y los parámetros principales de línea de comandos. Mientras las compilaciones diarias estaban orientadas a probar cambios rápidos, la rama 1.x prioriza compatibilidad, previsibilidad en el despliegue y soporte sostenido para herramientas derivadas.
¿Siguen siendo compatibles los modelos GGUF existentes con la versión 1.0.0?
Sí. El formato GGUF fue diseñado precisamente con versionado interno y metadatos autodescriptivos para mantener compatibilidad hacia atrás. Los archivos GGUF cuantizados previamente pueden cargarse directamente en llama-cli y llama-server v1.0.0 sin necesidad de reconversión.
¿Cómo funciona la aceleración híbrida entre CPU y GPU en Windows y Linux?
Mediante el parámetro -ngl (n-gpu-layers), llama.cpp asigna las capas iniciales o totales del transformer a la VRAM de la GPU usando CUDA, Vulkan o HIP. Si el modelo supera la memoria gráfica disponible, las capas restantes se mantienen en la RAM del sistema y se procesan en la CPU de forma transparente.
¿Se puede usar llama.cpp v1.0.0 como reemplazo directo de la API de OpenAI?
Sí, utilizando el binario llama-server incluido en el proyecto. Este servidor implementa los endpoints estándar /v1/chat/completions, /v1/models y /v1/embeddings, permitiendo apuntar cualquier SDK o aplicación compatible cambiando únicamente la URL base hacia localhost.
Darío Bernal
Informático y especialista en sistemas, optimización de software y tecnología práctica. Más de 5 años desglosando arquitecturas de software y hardware.